公众号:卡尔的 AI 沃茨
发文时间:2026 年 7 月 21 日 08:34
事情是酱黄瓜的。
上周有个读硕的朋友吐槽了一大轮他用的科研 Skill,大意是他写综述的时候引用了一篇文献,导师审稿时一查,发现那篇文献根本不存在。
AI 纯编的。
我当时随口回了一句,你去 ClawHub 上看看 Claude Code 的学术 skill 就好了。
他问我哪个好用,我没答上来。
上次写学术已经过去小一年,而且学术科研这个垂直领域的 skill,我确实没系统性地测过。我知道 GitHub 上有一堆,star 从几百到上万都有,但到底哪些的真能打的,我心里没底,评价不了一点。
所以我周末做了一件事,把 GitHub 上能找到的学术科研类 skill 全部拉下来,一个一个试。最后筛出九个比较有代表性的,从学科覆盖到功能设计到质控水平,认真过了一遍,做出来的视频也有 20 万播放了。
我发现,这个名单比我预估的要有料得多的多。
我复用了一下「从夯到拉」的排名,给这九个 Skill 排了五个档位,夯、顶级、人上人、NPC、拉。夯就是底子扎实换不同的 Agent 不同模型表现也够稳定,NPC 嘛。。。就是装了和没装区别不大的存在。至于拉,拉就是拉了。
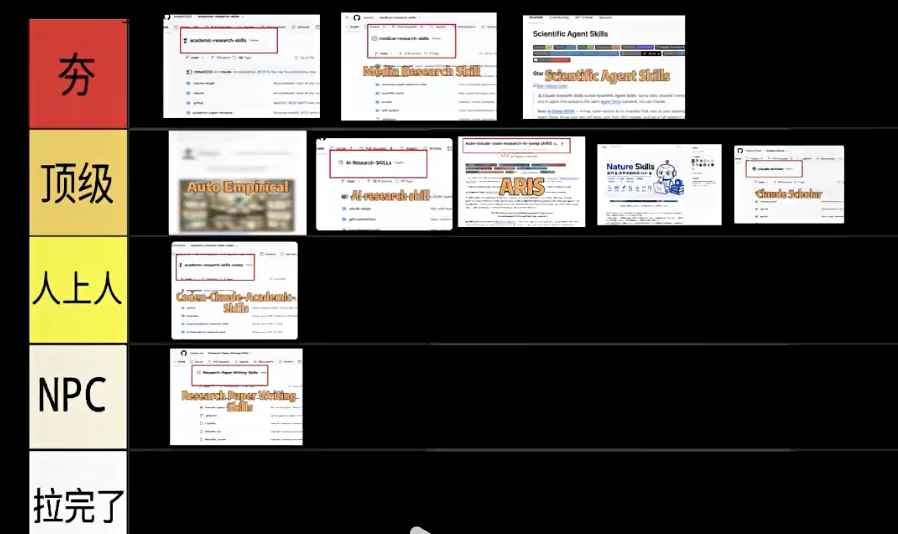
先说个好消息,这九个里面没有拉的,起码我这次筛出来的,最差也就 NPC 水平,不至于一坨。
Here we gogogo.
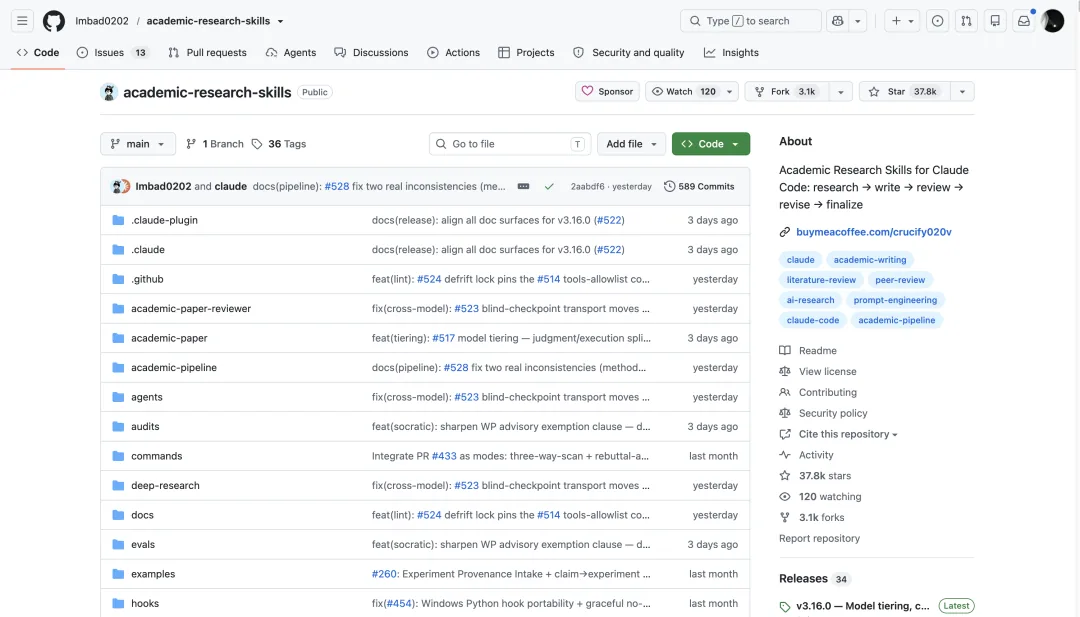
1,Academic Research Skills,给到夯
回到开头那个假引用的话题。
这个 skill 的杀手锏就是引用验证。每一条引用都要过 Semantic Scholar、OpenAlex()、Crossref、arXiv 四个数据库交叉验证,查不到的直接阻断,不让你把假引用混进论文。
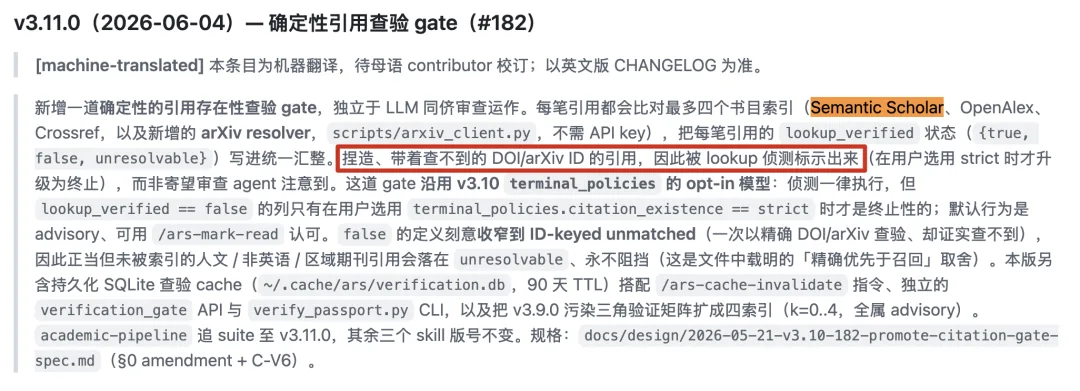
我测的时候故意给它塞了几条 AI 编的假引用,试试它能不能抓出来。
全被抓了。
不光全被抓了,它还会告诉你这条引用在哪个库能查到,在哪个库查不到,帮你判断到底是真的找不到还是你格式写错了。
这个功能对那些被 AI 幻觉坑过的人来说太刚需了,开头提到的那个硕士朋友现在就在用这个。
2, Research Paper Writing Skills, NPC
这个 skill 起的调贼高,就是直出论文不需要担心了,实际上我点进去项目看的时候,就发现底层其实是某位教授的公开笔记打包成的,一堆规则和提示语攒在一起。
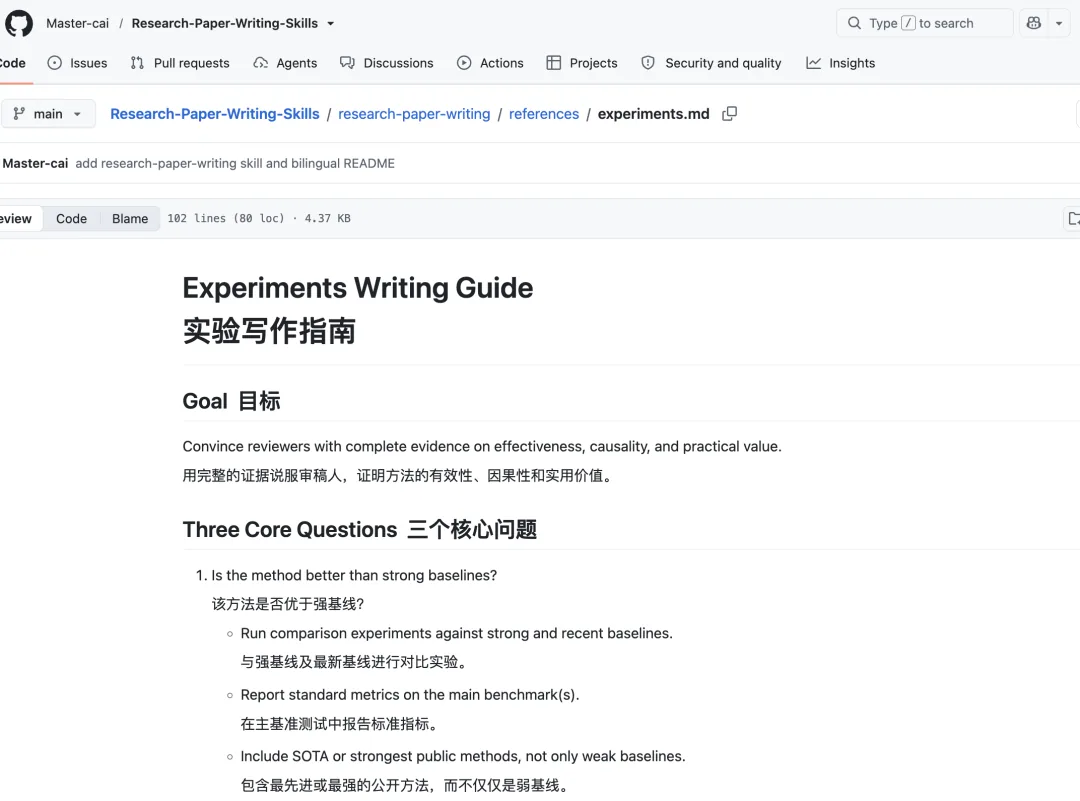
怎么说呢,就像有人把自己的考试笔记复印了一份给你。你照着来不会出大错,但它不会根据你的具体情况调整策略,也不会在你写到一半卡住的时候给你一个灵感。
就是一套规矩。所以只能给到 NPC。还不如我们自己搜几篇论文写作规范的帖子,手动喂给 codex。
3,codex-claude-academic-skills,给到人上人
这个它更适合工科背景的同学,尤其是天天跟 MATLAB 打交道的留子。信号处理,论文画图,数据可视化这一套,在其他 skill 里我还真没见到过。
我试了一下它的 MATLAB 信号处理模块,确实比通用 skill 深。你跟 Claude 说「帮我跑一个 FFT 然后画个频谱图」,普通 Claude 可能给你一段正确但很基础的代码。用了这个 skill 之后,它会考虑窗函数选择、频率分辨率这些细节,出来的东西是明显更专业。
,时长 00:12
但问题也明显,没什么质控。
它不是一个设计严谨的学术工作流,就是一个人的个人工具箱,刚好这个人是做工科的。
4,Claude Scholar,顶级
写文献综述的同学的福音来了。这个拿来做做 PPT 之前的背景调查也是非常好用的
这个 skill 的核心能力是管理和阅读文献,它能接 Zotero,所以说首先文献库直接就通了,能支持按 DOI、arXiv 号导入论文,批量读文献做笔记,还能连 Obsidian()。
我试了一下,给它丢了十篇论文,它帮我做了一份结构化的文献笔记,标注每篇的核心贡献,方法论差异和引用关系。光是省下来的时间就值了。我自己之前还是去 arxiv 上先下 pdf,再导入 Zotero,然后再更新信息啊,打标签去重啊,一篇篇文章看着做标注啊,非常痛苦而且 Zotero 的搜索做真的太烂了,做综述的时候平均一两句话就引用论文的场景简直就是痛苦中的痛苦面具。
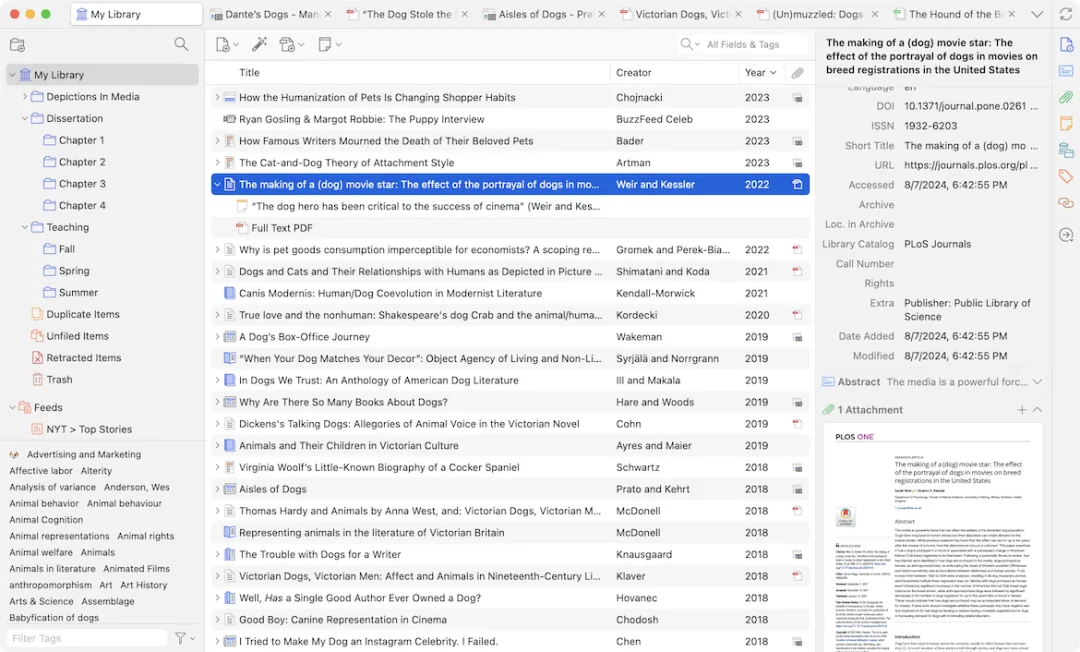
Claude Scholar 相当于把这个苦力活包圆了,把文献批量导入,自动做摘要笔记,标注方法论差异。我可以拿着这些笔记再去做判断和综合。
5,Scientific Agent Skills,夯
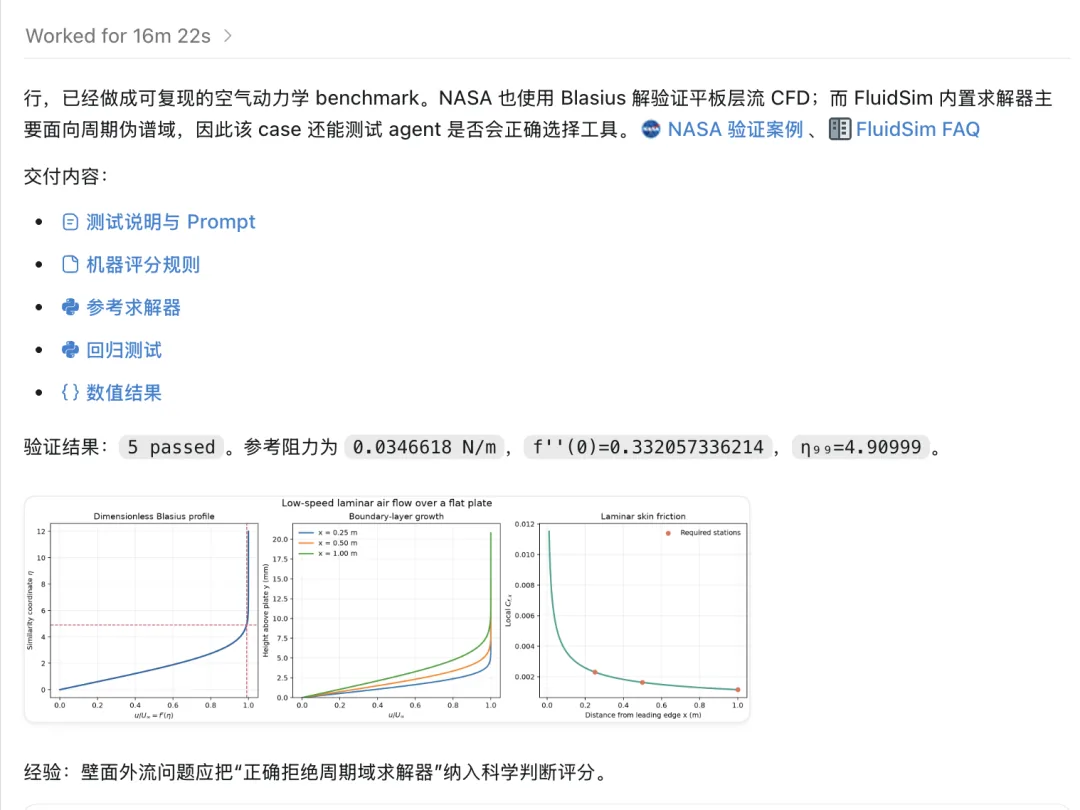
这个 skill 帮我跑科学计算。
它封装了 RDKit、Scanpy 这些专业工具库,处理实验数据的时候特别顶。如果是搞信息学等这些方向,这个 skill 能省配环境的功夫。
我试的时候让 GPT5.6 给我出了一个题,用这个 skill 跑了一个比较经典的空气流体力学计算模型,基本上就是开箱即用的,没有什么说要先配两小时环境,手动调整数据参数什么的。
6,AI-Research-SKILLs,顶级
这个名字容易让人误解。它翻译过来很容易以为是「用 AI 做研究的 skill」,其实它的定位是「给做 AI 研究的人准备的 skill」。
属于是遇到我专业对口了。模型架构,微调,RAG,九十多个 skill 全套覆盖。如果你是做深度学习的,这基本就是一个开箱即用的工具箱。
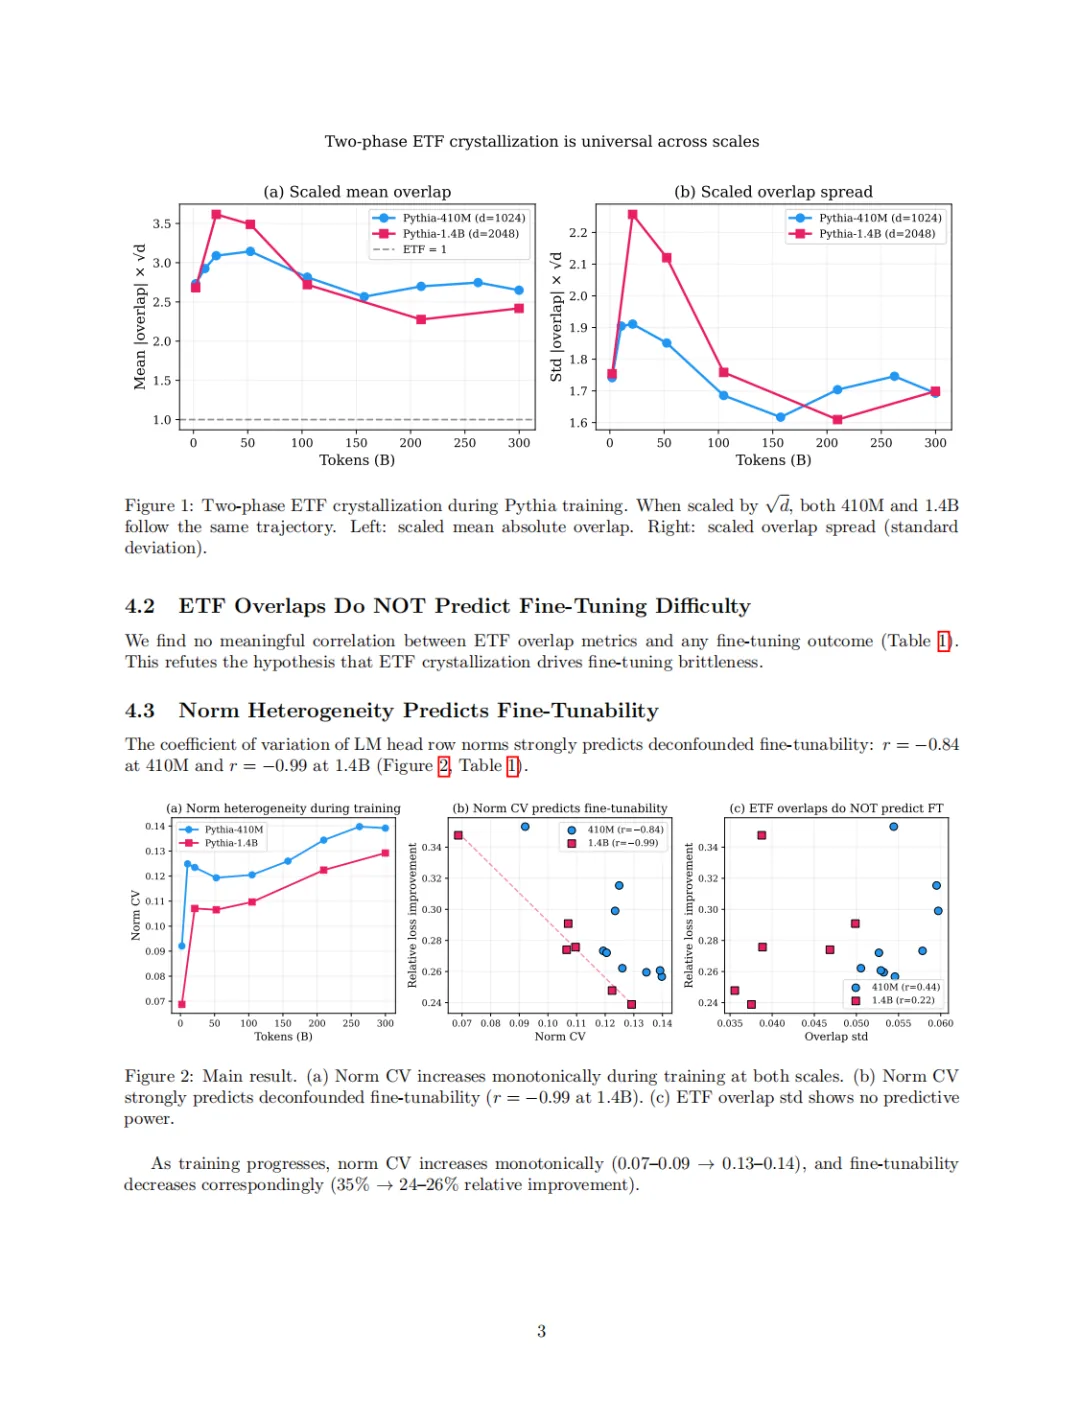
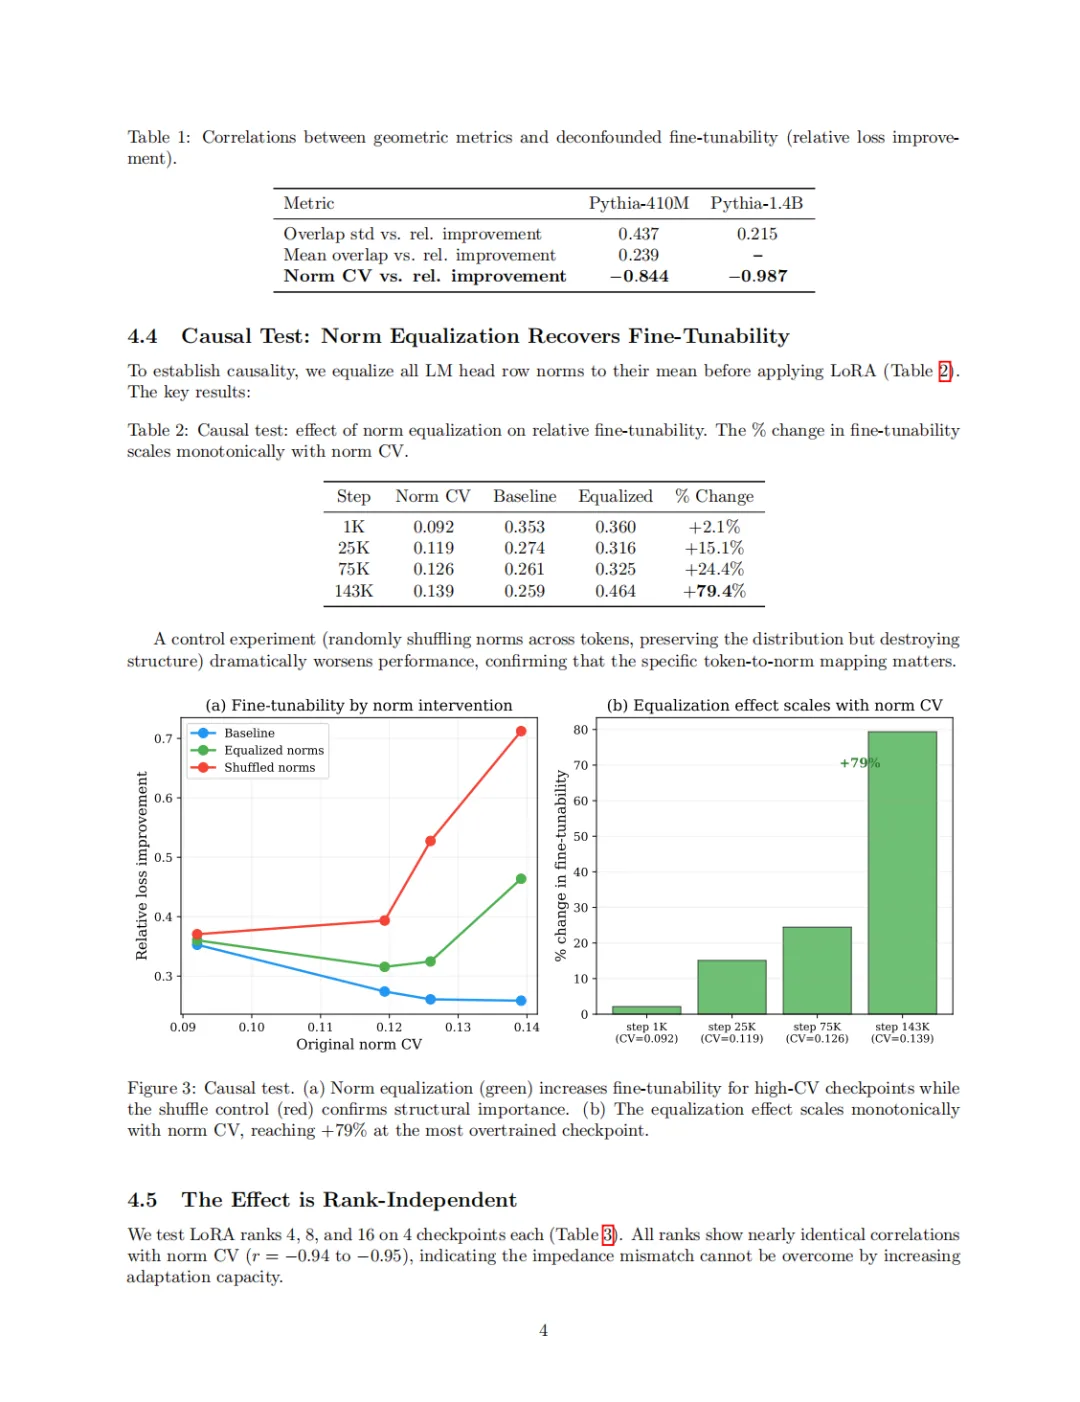
我试了一下微调相关的 skill 搓了一下 GPT2 的微调,跟它聊训练策略,它会根据你的数据量和硬件条件给出合理建议,是能直接拿去跑的配置。
理科同学做 AI 方向的,基本不白来,九十多个 skill 质量都挺硬。
7,Auto Empirical,顶级
这个是有斯坦福背景的,是给社科同学跑实证的。
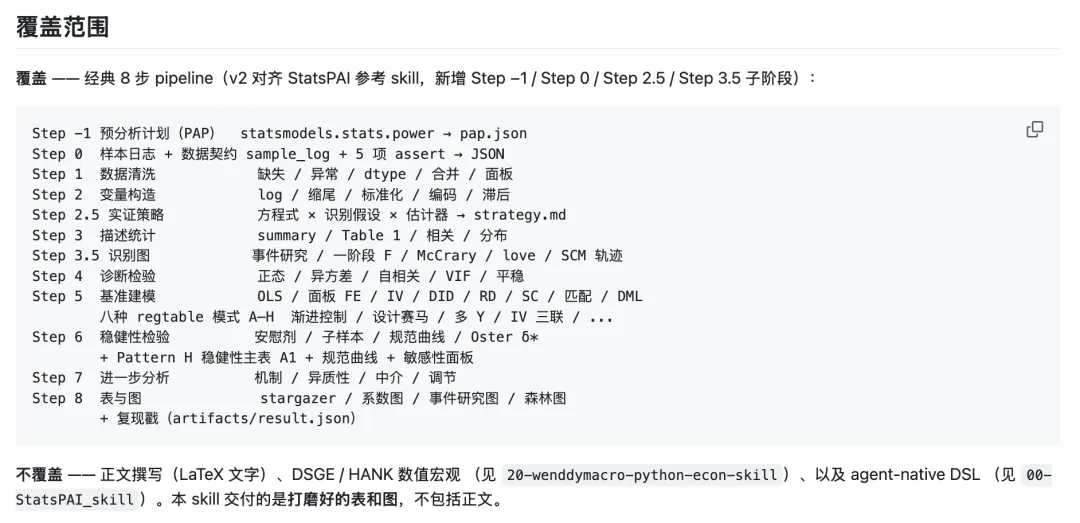
七十个 skill,从数据清洗到建模到表图输出全覆盖,Auto Empirical()把这个流程工具化了。质控是全场最扎实的,它不会跳过任何一个环节。
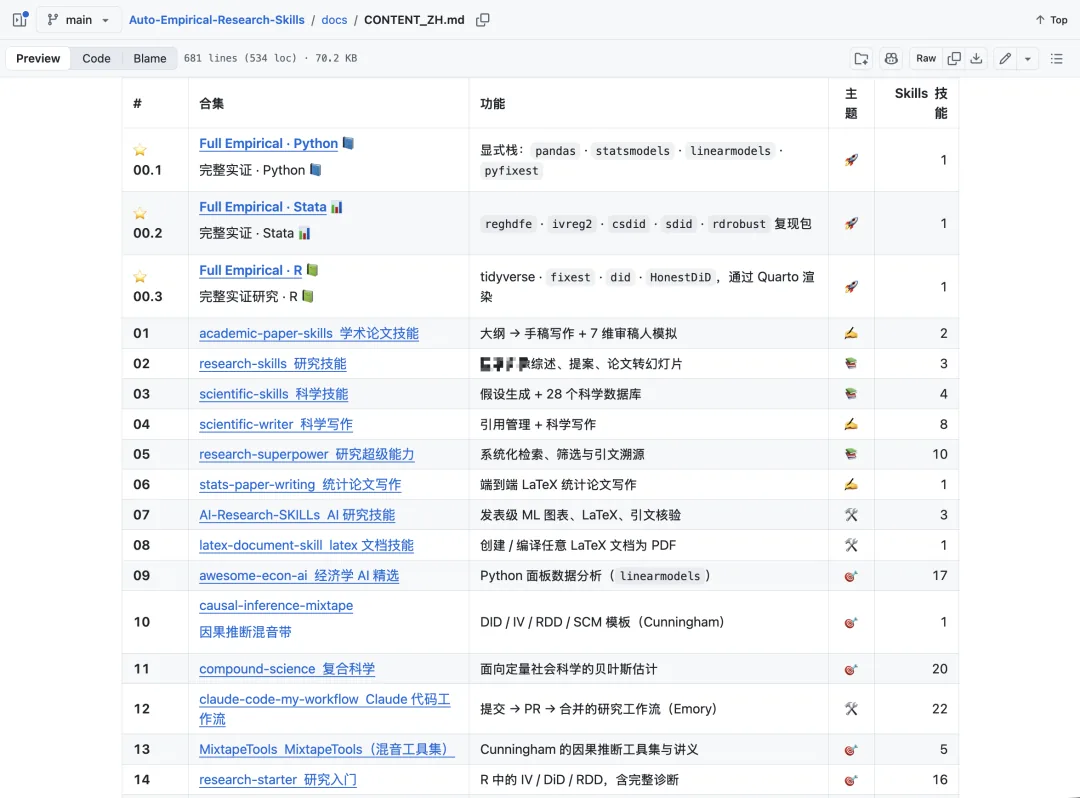
如果还在手动写 Stata,python 代码跑回归真的可以试试看。
8,nature-skills,顶级
说到写论文最大的痛点,英文写作在我心目中绝对排前五。
虽然已经有 humanize 这个经典 skill 给我平时写英文邮件兜底去翻译腔味,但距离 Nature 腔还差点意思,我直接上一段文本就能看出来了,给它丢了一段写得比较中式英语的论文段落。
## 修改前Humans can infer how objects are likely to move from passive observation: a cup may be lifted, a drawer may slide, and a lid may rotate shut. Such predictions expose the physical consequences of interaction needed to act in the real world. We study how to learn this anticipation from ordinary monocular videos of human-object interaction. ## 修改后Humans can infer from passive observation how objects are likely to move when manipulated: a cup may be lifted, a drawer may slide and a lid may rotate shut. These predictions reveal the physical consequences of interaction that underpin action in the real world. Here we investigate how such anticipatory knowledge can be learned from ordinary monocular videos of human–object interactions.【这个片段摘要自 MotionForesight: Re-purposing Video Models for Future 3D Scene-Flow Prediction】
我把这段丢给我托福老师看了,来转达一下,
确实不一样,不像 Grammarly()那种简单的语法修正,nature-skills 针对的是整个段落的表达方式。用词和句式更符合学术风格。
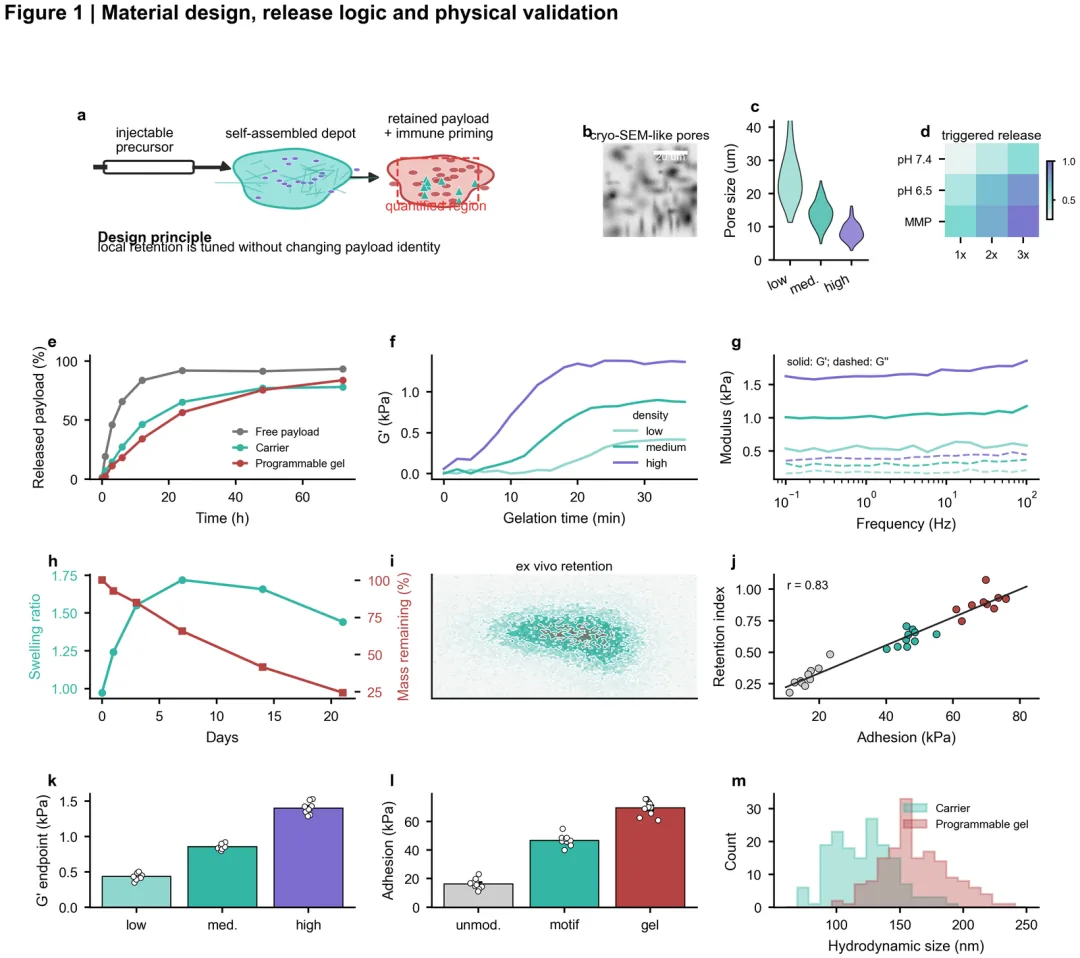
除了润色它还能做发表级别的配图,给到顶级可能都有点低了。
9,ARIS,给到人上人
ARIS 这个 skill,思路跟前面 8 个都不一样。
它的核心玩法是,无人值守,跟 Codex 目标模式差不多。
你把论文稿子扔给它,设好参数,然后直接原地睡觉。它帮你跑一整晚。改稿、查文献、调结构、优化表达。早上醒来打开电脑的时候,稿子已经被改了好几轮了。
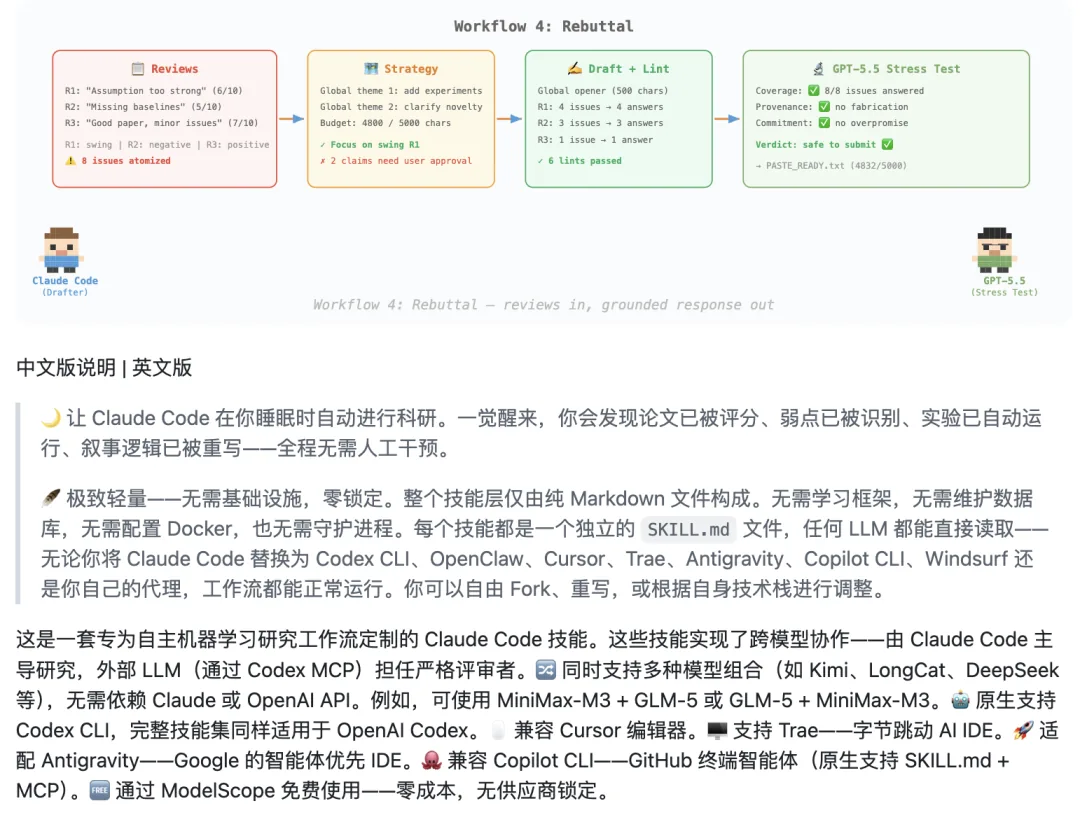
看一眼就不信的我实际测了一下,它确实能做到无人运行。但离谱的是开发者自己也承认了,无人值守的时候,这框架遇到需要数据支撑的地方,如果 API 没有实时联网搜索能力,它就会现场编一个数据。。。
所以你早上起来看的稿子不能直接用,得自己过一遍,验证它晚上改的东西靠不靠谱。
我现在能想到的就是把 ARIS 跟前面第五个聊的 Academic Research Skills 可以搭配用。ARIS 晚上改完稿,你早上拿 Academic Research Skills 跑一遍引用验证,把假引用全揪出来。两个配合,基本就是一条半自动的流水线。
OK 啊,九个说完了。
本来还以为会遇到几个凑数的水货,但实际上能在 GitHub 上积累到一定关注度的学术 skill,质量比我想象的高。
而且我注意到一个事儿,这些 Skill 里质量最好的,都不是那些技术公司做的产品,都是真正在做科研的人自己做的,是他们用 Skill 的形式把自己的方法论开源出来了。
今天科研 skill 自带的争议性,让我联想到了 17 年微信推出小程序的时候。
很多人不看好,觉得这玩意能干嘛,手机上装个 App 不就完了。后来发生了什么大家都知道了,就是因为小程序把开发和分发的门槛降到了一个临界点以下,让更多人能参与进来。
Skill 对于学术研究来说,可能也一样。有人担心论文注水,有人担心学术诚信,有人担心大家变成 AI 的提线木偶。
这些担心我觉得都合理。
但仔细想想,计算器刚出来的时候,也有人说学生会变得不会算数。Excel 刚出来的时候,也有人说会退化成只会按按钮的纯纯工具人。
这些变化都发生了。但结果是什么?是那些学会用新工具的人能做的事比以前多了,行业整体的上限也被拉高了。
所以,当 AI 能帮我们搞定 90%的格式化工作,对有想法的人来说其实是好事来的,能有大把的时间去想论文了,再不用把时间花在调论文格式上。
最后的最后,给大家留一个速查表,
写论文防假引用,Academic Research Skills。
跑数据做实验分析,Scientific Agent Skills。
润色英文到发表水准,nature-skills。
想让 AI 替你通宵改稿,ARIS。
管理和批量阅读文献,Claude Scholar。
跑社科实证,Auto Empirical。
做 AI 和深度学习研究,AI-Research-SKILLs。
工科 MATLAB 信号处理(),codex-claude-academic-skills。
以及,如果你实在不知道装什么,装个 Research Paper Writing Skills 当个氛围组也行。
这个 Skills 清单会越来越长的。
我坚信。
@ 作者 / 卡尔