公众号:精神抖擞王大鹏
发文时间:2026 年 6 月 9 日 02:55
上一篇文章我们从源码分析了 Claude Code 的子智能体。Claude Code 的做法是:LLM 根据任务复杂度自主决定是否派生子 Agent。用户也可以自主触发,通过 agent() 定义文件()配置,或通过每次显式请求来指定子 Agent。
而 OpenAI 的 gpt Codex 给出了一套不同的答案。在当前稳定版(V1,,默认开启)中, 工具的描述对 LLM 有一条明确的硬约束:
Only use `spawn_agent` if and only if the user explicitly asks for sub-agents,delegation, or parallel agent work.Requests for depth, thoroughness, research, investigation, or detailed codebaseanalysis do not count as permission to spawn.也就是说,除非用户明确要求"帮我并行做"、"委派子任务",Codex() 不会主动 spawn 子 Agent。这和 Claude Code 的"LLM 自主决策"是反过来的。
注:Codex 内部还有一个 V2 版本(,默认关闭),去掉了这条约束,允许 LLM 自主决定。V2 已实现但未稳定,可以在 中手动开启:
[features.multi_agent_v2]enabled = true本文以两个版本的源码为基础,侧重分析已稳定的 V1 机制,同时标注 V2 的差异。
Codex 的多 Agent 是什么
子 Agent 的本质:独立的 LLM 会话
当用户说"帮我并行重构这几个模块"时,Codex 主 Agent 会调用 工具创建子 Agent。这里的核心区别是:
- • Claude Code:子 Agent 也是工具,但整个子会话在一次工具调用内部完成--调用返回时子 Agent 已经跑完,结果直接作为 tool_result 回来
- • Codex:
返回时子 Agent 刚刚启动,它是一个独立的 LLM 会话,在后台持续运行
Claude Code 的子 Agent 是一次性的--不管同步还是异步(后台)模式,跑完就销毁,父 Agent 拿到结果后不能再跟它交互。Codex 的子 Agent 是持续存活的--创建后独立运行,父 Agent 可以反复与它通信、追加任务、中断、甚至关闭后恢复。
正因为子 Agent 是独立存活的,它的生命周期就需要父 Agent 来管理。子 Agent 启动后在后台跑,父 Agent 可以继续做其他事,但当父 Agent 需要子 Agent 的结果才能继续时,就调用 阻塞等待。如果中途发现需要给子 Agent 补充信息,用 (V1)或 (V2)发一条消息过去。子 Agent 做完了一步但还想让它接着做下一步,调 (V2)追加任务并唤醒它。发现子 Agent 方向走偏了,调 (V2)立即叫停。任务全部完成后,调 关闭子 Agent 释放并发位。如果后来又需要它, 可以从磁盘恢复之前的会话继续工作。想看当前有哪些子 Agent 还活着,用 (V2)查看全局状态。
这套工具覆盖了子 Agent 从生到死的每个阶段:创建 → 通信 → 等待 → 追加 → 中断 → 关闭 → 恢复。
spawn_agent 的参数
// V1 版本structSpawnAgentArgs { message: Option<String>, // 任务描述 items: Option<Vec<UserInput>>, // 富文本输入 agent_type: Option<String>, // 角色:explorer / worker / default model: Option<String>, // 模型覆盖 reasoning_effort: Option<ReasoningEffort>, service_tier: Option<String>, fork_context: bool, // 是否 fork 父级上下文}// V2 版本新增structSpawnAgentArgs { message: String, // 必填 task_name: String, // 必填,形成树状路径 fork_turns: Option<String>, // "none" / "all" / "3"(替代 fork_context) // ...其余同 V1}V2 的核心变化:引入 形成树状寻址路径, 支持精细的上下文继承粒度。
树状路径寻址
V1 中子 Agent 用 UUID()标识,比如 。当只有一层子 Agent 时这没问题,但一旦子 Agent 再创建子 Agent,UUID 就有两个缺陷:
- • LLM 无法从 ID 理解层级关系--看到两个 UUID 不知道谁是谁的子级
- • 不能按子树过滤--想查"某个 worker 下的所有子任务"做不到
V2 引入了树状路径解决这个问题。每个子 Agent 有一个可读的路径地址:
/root ← 主 Agent(用户对话)/root/explore_auth ← explorer 子 Agent/root/impl_frontend ← worker 子 Agent/root/impl_frontend/fix_css ← worker 的子 Agent好处是:
- • 相对引用 -
的子 Agent 可以直接用引用同级,不用记 UUID - • 按前缀过滤 -
只看某个子树 - • LLM 可读 - 路径本身就表达了层级关系,比 UUID 更利于 LLM 决策
源码中的解析逻辑:
// codex-rs/core/src/agent/control.rspub(crate) async fn resolve_agent_reference( &self, current_session_source: &SessionSource, agent_reference: &str,) -> CodexResult<ThreadId> { let current_agent_path = current_session_source .get_agent_path().unwrap_or_else(AgentPath::root); let agent_path = current_agent_path .resolve(agent_reference) .map_err(CodexErr::UnsupportedOperation)?; // 查注册表找到对应 ThreadId}子 Agent 的类型
spawn 时可以通过 指定子 Agent 的类型。不同类型本质是不同的配置层,决定子 Agent 的行为边界。
最常用的是 --当主 Agent 想知道"某个函数在哪里定义的"、"这个模块的依赖关系是什么"时,派一个 explorer 去查。explorer 的 prompt 约束它只读不写,快速返回结果。工具描述中还鼓励"并行派多个 explorer 回答不同问题"、"复用已有 explorer 问相关问题"。
需要实际改代码时用 --实现功能、修 bug、拆分重构。worker 的 prompt 要求它明确自己负责哪些文件,且不能 revert 其他 worker 的改动--因为可能有多个 worker 并行修改不同模块。
不指定类型时用 ,继承父级的所有配置,不做额外约束。
角色的实现机制是 config 层叠--每个角色对应一个 文件,作为高优先级配置层插入子 Agent 的 Config 中:
// codex-rs/core/src/agent/role.rspub(crate) async fn apply_role_to_config(config: &mut Config, role_name: &str) { let role_layer_toml = load_role_layer_toml(config, config_file, ...).await?; // 作为 SessionFlags 优先级层插入 config stack *config = reload::build_next_config(config, role_layer_toml, ...).await?;}用户也可以在 的 中自定义角色。
除了工具和类型,Codex 还在 的工具描述中注入了约 2000 字的委派策略--相当于在工具定义里内嵌了一份「项目管理手册」。核心规则包括:阻塞任务别委派(你下一步就需要结果的事,自己做更快)、独立信息获取并行 spawn explorer、大实现拆成不重叠的模块并行 spawn worker、 尽量少调用、不要重复做已委派的任务。V2 还支持通过 配置项为根 Agent 和子 Agent 分别注入不同的策略提示。
内部怎么实现的
spawn_agent 执行链路
上一部分我们知道了: 会创建一个独立的 LLM 会话,这个会话有路径、有类型、有状态、可以被反复交互。但从 LLM 发出一次 调用到子 Agent 真正开始跑,中间具体发生了什么?
这条链路要处理四件事:检查是否允许创建(深度 + 并发位)、给子 Agent 建立身份(路径 + 昵称)、决定子 Agent 带着什么上下文启动(fork or not)、确保子 Agent 完成时父 Agent 能收到通知(completion_watcher)。下图展示了完整流程:
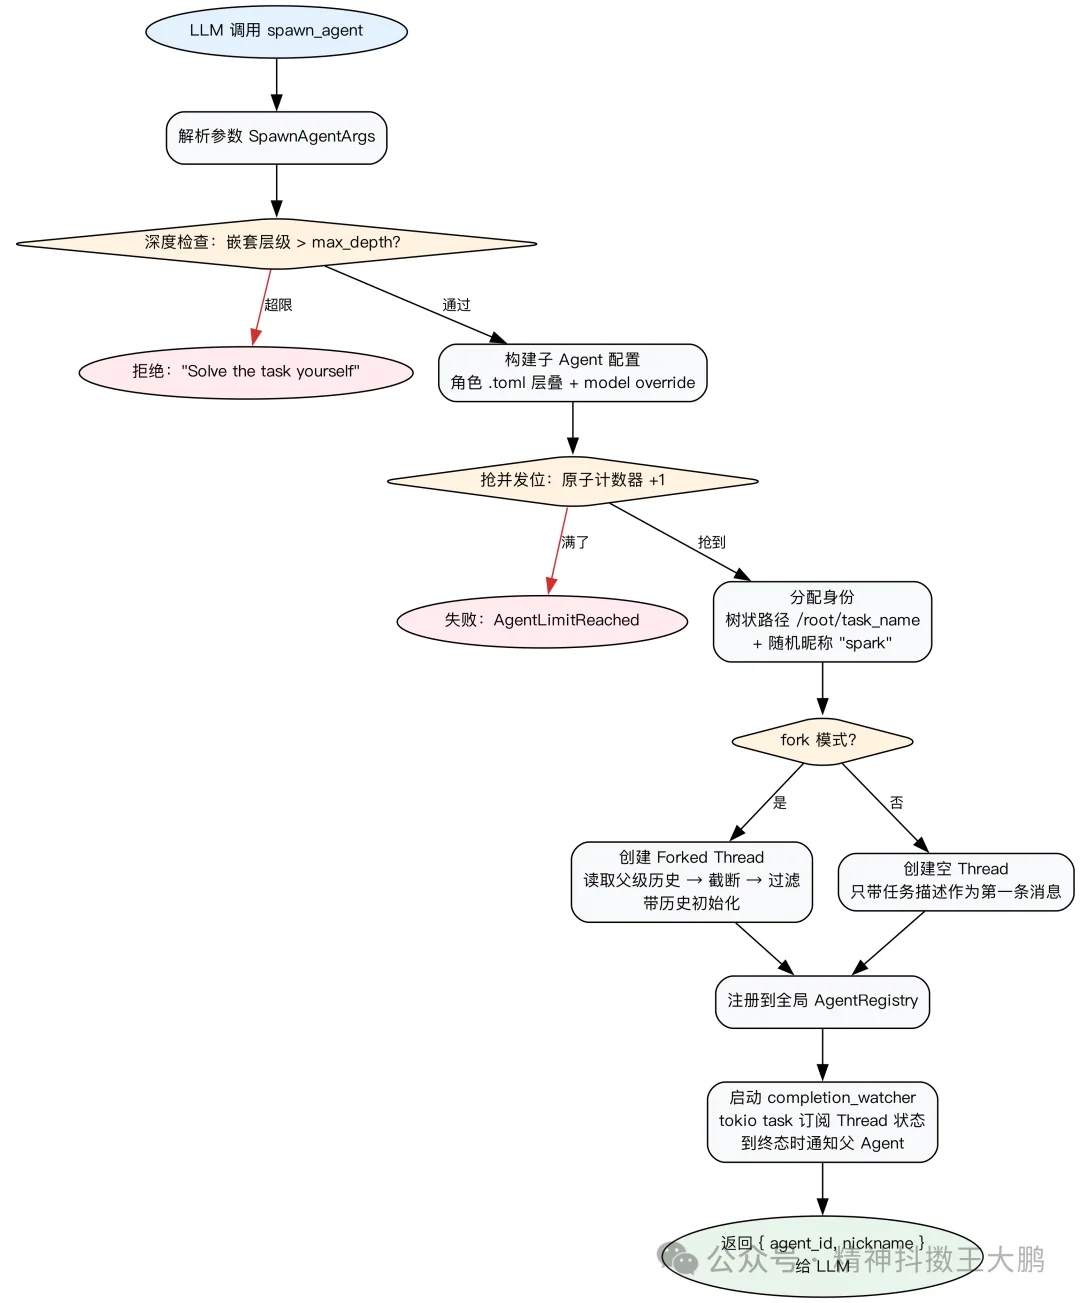
完整实现见 的 。
Thread 的内部结构
spawn 链路中最核心的一步是"创建 Thread"--它是子 Agent 的运行载体。创建出来的这个 Thread 有两个关键特性,支撑了后面所有的协作机制:
一是 Rollout 持久化--每个 Thread 的对话历史会写入磁盘。这意味着子 Agent 被 关闭后, 可以从磁盘恢复完整上下文继续工作;进程崩溃后也能恢复现场。
二是状态机 + watch channel 广播--每个 Thread 有一个状态:
pending_init → running → completed(message?) → errored(message) → interrupted → shutdown状态变更通过 channel 广播给所有订阅者。这是后面两个机制的基础:
- •
订阅子 Agent 状态,到终态时自动向父 Agent 推送通知(推) - •
订阅同一个 channel,带 timeout 等待终态(拉)
理解了这两点,接下来看 Agent 之间如何通信就很自然了。
通信:InterAgentCommunication 协议
上一节讲的 watch channel 只广播状态信号(running/completed/errored),不携带实际内容。Agent 之间传递实际信息--任务指令、补充说明、完成摘要--靠的是另一套机制:消息协议。
两者的关系是:watch channel 提供触发时机, 承载实际内容。比如子 Agent 完成时,completion_watcher 通过 watch channel 感知到终态,然后构造一条 消息(包含完成摘要)发给父 Agent。
pub struct InterAgentCommunication { pub sender: AgentPath, // 发送者 pub recipient: AgentPath, // 接收者 pub content: String, // 消息内容 pub trigger_turn: bool, // 是否唤醒接收者做一次 LLM 调用}所有通信都走这一个结构,关键区分在 :
- • true:立即唤醒--消息送到后触发接收者做一次 LLM 调用。两种场景会用到:•
的初始任务--子 Agent 刚创建,需要被唤醒开始工作•--子 Agent 已经 idle,追加新任务时需要再次唤醒 - • false:只排队--消息放进接收者的队列,等它下次运行时才看到。两种场景:•
--补充信息,不需要打断子 Agent 当前工作• 子 Agent 完成通知--completion_watcher 发给父 Agent 的结果摘要,父 Agent 下次运行时看到
子 Agent 完成时,父 Agent 收到的通知格式如下:
<subagent_notification>{"agent_path": "/root/explore_auth", "status": {"completed": "Found 3 auth implementations..."}}</subagent_notification>这条通知作为一条 的消息插入父 Agent 的消息队列。父 Agent 在下一次 LLM 调用时看到它,决定是否需要基于结果继续操作。
wait_agent:主动拉取结果
completion_watcher 是"推"--子 Agent 完成时自动通知父 Agent,但父 Agent 只能在下次 LLM 调用时才看到。如果父 Agent 当前就需要子 Agent 的结果才能继续,就用 主动拉取。
的核心设计是带 timeout 的等待:
- • 默认超时 30 秒(可配置,范围 0~3600000ms)
- • 支持一次 wait 多个子 Agent--任一完成就返回
- • 如果子 Agent 已经完成,立即返回结果,不等待
- • 超时后返回
,而不是报错
为什么不是无限等待?因为 LLM 需要在超时后有决策权--可以先去做其他不依赖这个结果的工作,可以再 wait 一次,也可以决定不等了直接继续。这保证了主 Agent 永远不会被子 Agent 卡死。
实现上用的是同一套 watch channel + tokio timeout,不是轮询。完整实现见 。
Fork:继承父级上下文
spawn 链路图中有一个 fork 分支:创建 Thread 时是带着父级历史启动,还是从零开始?这里展开它。
场景:用户跟主 Agent 聊了 20 轮确定了需求,然后 spawn 一个 worker 去实现。这个 worker 需要知道需求是什么,否则从零开始根本不知道做什么。这时就需要 fork--让子 Agent 继承父级的对话历史。
三种模式:
- • 全量继承(V1:
/ V2:)--带上父级全部历史。适合子 Agent 需要完整背景的场景 - • 最近 N 轮(V2:
)--只取最近几轮。适合父级历史很长但只有最近的讨论相关,避免浪费 token - • 不 fork(V1:
/ V2:)--干净启动,只带中的任务描述。适合任务自包含、不需要前置上下文的场景
fork 时不是把父级历史原封不动拷过去。源码中有一个过滤步骤:只保留 system/developer/user 消息和 assistant 的最终回答,丢弃中间的工具调用和推理过程。这样子 Agent 获得的是简洁的"结论性上下文"而不是充满噃声的完整日志。
完整实现见 的 和 。
为什么这样设计
前两部分分别讲了 Codex 多 Agent 是什么、怎么实现的。现在回答最根本的问题:为什么 Codex 要把子 Agent 做成持久化 Thread,而不是像 Claude Code 那样做成工具调用返回结果?
因为两者想解决的问题不同。Claude Code 想解决的是"任务太复杂,一个 Agent 的上下文装不下"--所以派一个子 Agent 去做一块,做完拿结果回来,本质是"分活"。而 Codex 想解决的是"多个 Agent 像团队一样持续协作"--任务可以追加、方向可以调整、进度可以追踪、工作可以中断后恢复。
这个目标决定了子 Agent 必须是持续存活的实体。如果子 Agent 只是一次工具调用,那么:追加任务做不到(调用已经在跑,不接受新输入)、中断保留现场做不到(kill 了就没了)、崩溃恢复做不到(运行状态在内存里)。
但这个设计选择带来了代价:持久化 Thread 不会自动消失,它会一直占着资源直到被显式 close。这迫使 Codex 引入三层并发控制:
- • spawn 总数上限(AgentRegistry)--防止 Thread 占满内存
- • 并发执行数(AgentExecutionLimiter)--同时只有 N 个跑 LLM 调用,避免 API 爆炸
- • 嵌套深度--防止无限递归
而 Codex 默认允许嵌套(子 Agent 再创建子 Agent),进一步放大了资源风险。为什么允许?因为它的子 Agent 类型有明确分工--explorer 探索到子问题需要再派 explorer,worker 实现大模块需要再拆子 worker。树状路径天然支持多层寻址,深度限制兜底。Claude Code 默认禁止嵌套,是因为它的子 Agent 没有类型分工,放开容易失控。
所有这些加在一起,spawn 就是一次重操作。如果 LLM 自由 spawn,容易打满并发位、产生大量 idle Thread、并行修改同一文件造成冲突。这就是 V1 为什么要求用户明确说"并行做"才会 spawn--用显式许可代替自动判断,把风险决策权交给用户。
V2 放开了这个限制,但不是直接放开不管--配套了更精细的回收机制: 默认 4、 可以叫停走偏的 Agent、 显式释放资源。用更精细的工具替代了粗暴的"不许 spawn"。